
Google heeft Gemini 4 Carbon geïntroduceerd, een geavanceerd AI-model voor programmeren, langdurige agenttaken en cyberbeveiliging. Google noemt Carbon zijn krachtigste model, maar het is nog niet publiek beschikbaar. Vroege toegang is beperkt tot een kleine groep beveiligingsspecialisten.
Langdurige agent-workflows en softwareontwikkeling
Carbon is ontworpen om agenttaken die meerdere dagen duren vol te houden, de voortgang in complexe projecten bij te houden en bruikbare software op te leveren. Google noemt interne voorbeelden waarin het model meerdere dagen bleef doorwerken, doodlopende paden overwon en de oorzaak van subtiele bugs in grote codebases en systemen op laag niveau wist te achterhalen. Het model moet problemen kunnen opdelen in kleinere stappen, het resultaat van elke actie evalueren, bij falen alternatieve aanpakken kiezen en oplossingen leveren die rekening houden met projectbeperkingen.
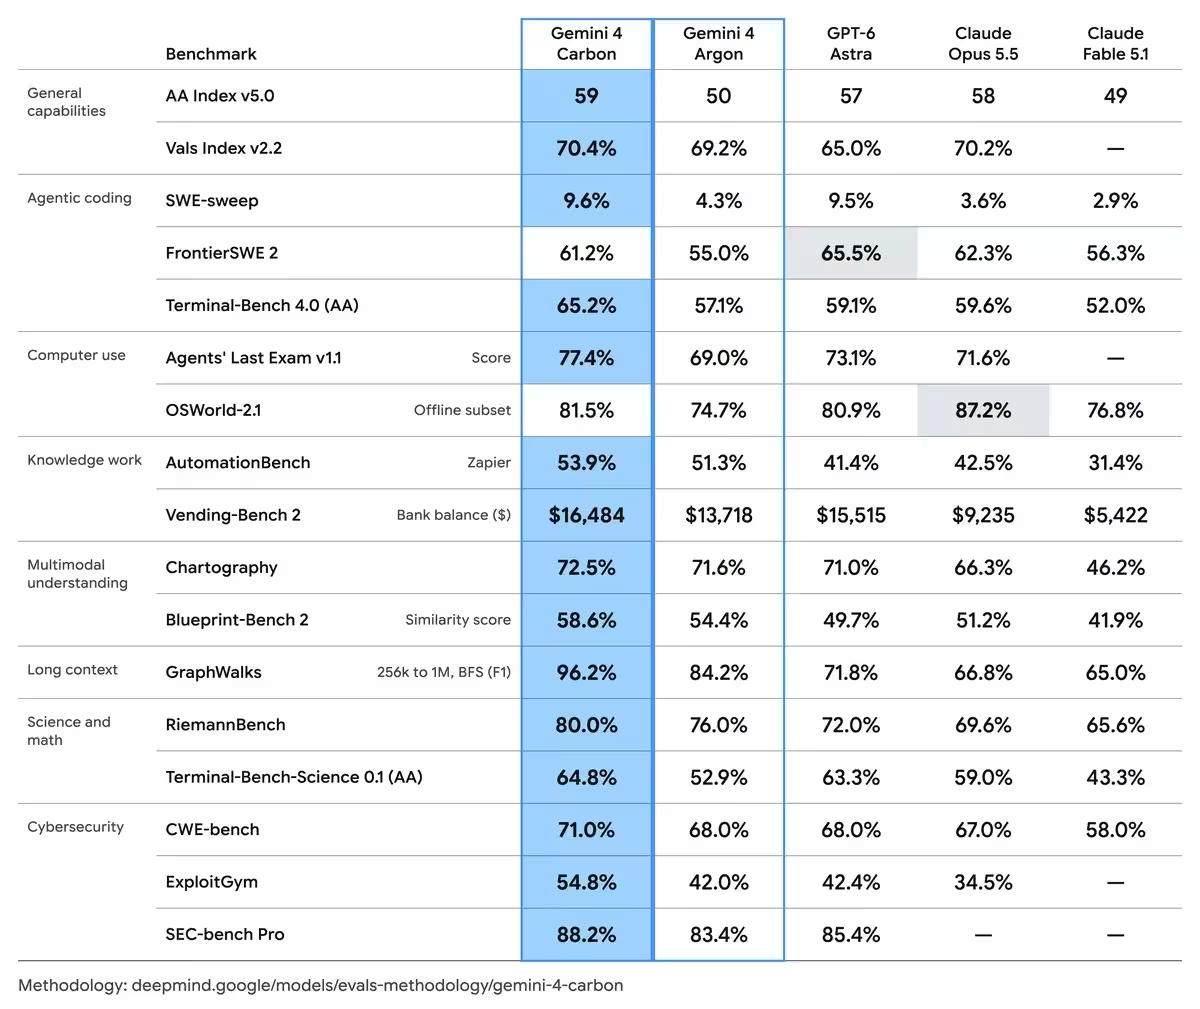
Volgens Google laat Carbon verbeteringen zien op het gebied van wetenschappelijk redeneren, multimodaal begrip, volledige webontwikkeling en het genereren van bruikbare output. In versie 5.0 van de Artificial Analysis Intelligence Index behaalde Gemini 4 Carbon een score van 59, goed voor de eerste plaats. In WebDev Arena steeg Carbon met 89 punten naar een score van 1769 en eindigde het model op de vierde plaats. Google benadrukt dat deze metriek de kwaliteit van output meet via directe vergelijkingen tussen antwoorden en geen garantie biedt voor identieke prestaties in alle realistische projecten.
Driestapsworkflow voor cyberbeveiliging en benchmarkresultaten
Google positioneert Carbon rond een driestapsworkflow voor cyberbeveiliging: het vinden van een echte kwetsbaarheid in een grote codebase, het beoordelen van de exploitbaarheid en het produceren van een oplossing die de grondoorzaak aanpakt.
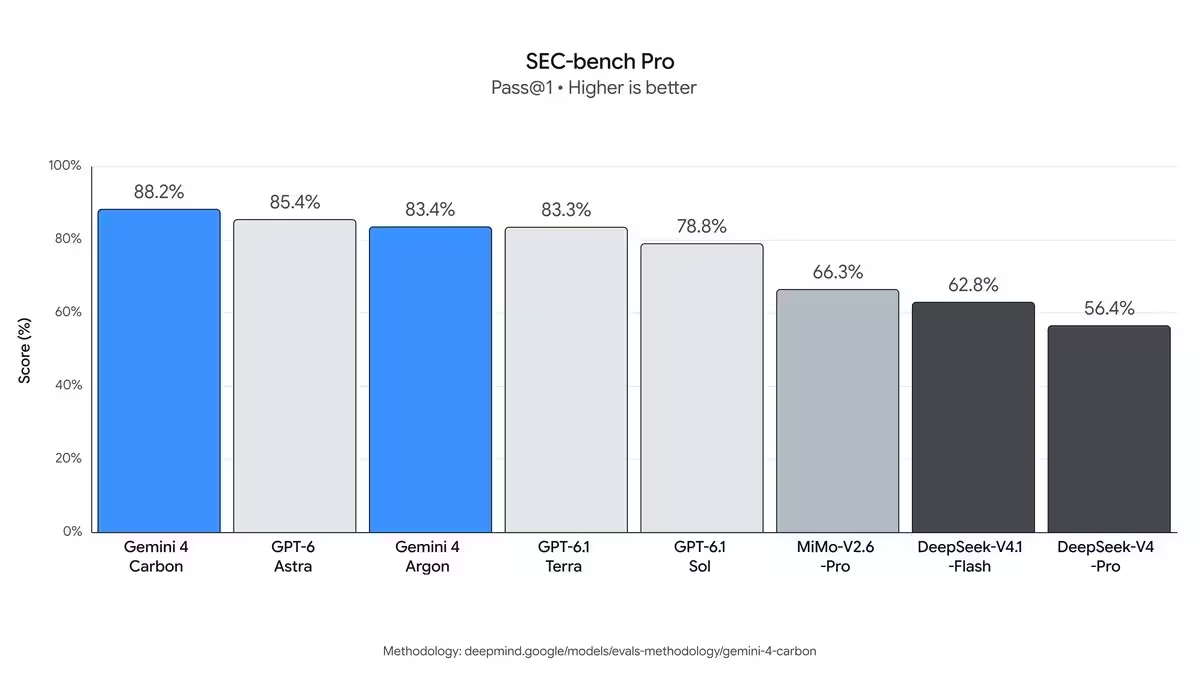
- Opsporing: Carbon scoorde 88,2 procent op SEC-bench Pro en identificeerde automatisch complexe, verborgen gebreken in echte software.
- Validatie van exploits: Carbon scoorde 54,8 procent op ExploitGym, dat beoordeelt of een model de exploitbaarheid kan inschatten.
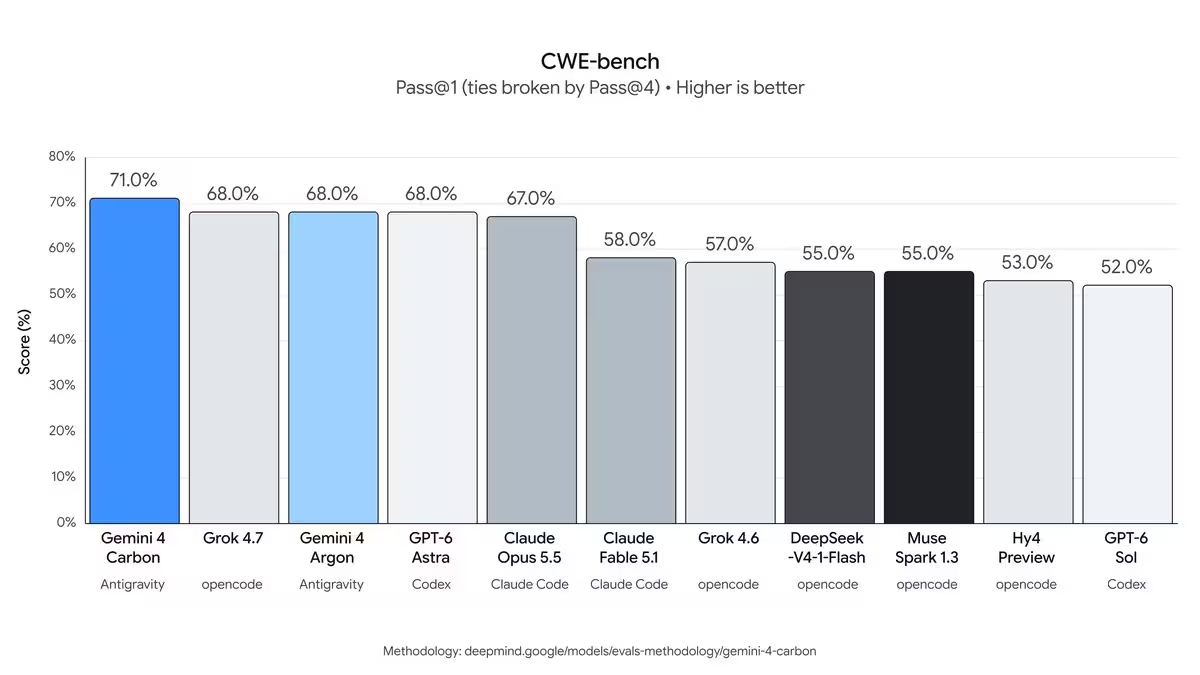
- Herstel van de grondoorzaak: Carbon scoorde 71 procent op CWE-bench van Collinear en zette geldige bevindingen om in uitvoerbare patches.
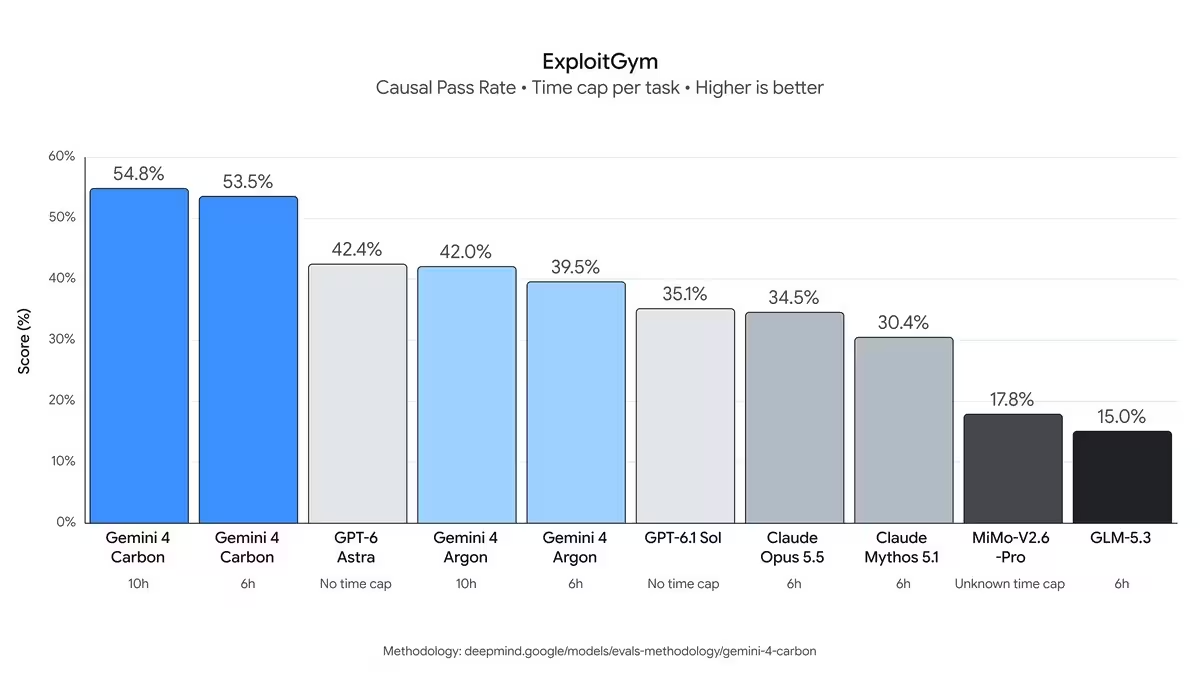
Deze externe tests werden zonder beveiligingslagen uitgevoerd, zodat de onbewerkte capaciteiten van het model konden worden gemeten. Google waarschuwt dat productie-implementaties beperkingen en systemen voor misbruikdetectie zullen bevatten. Uit interne evaluaties bleek dat de slagingskans van Carbon bij het produceren van veilige code meer dan twee keer zo hoog was als die van Argon. Het Chrome-team meldde dat Carbon fixes van hogere kwaliteit produceerde in meer dan tien keer het tempo van een groot, niet nader genoemd model uit een ander lab. Google maakte de concurrent en de volledige testmethodiek niet bekend. Beveiligingsplatform Wiz zag eveneens voordelen van Carbon in webpenetratiemetrics die binnen zijn Scan for Good-programma worden gebruikt.
Veiligheidsarchitectuur, weerbaarheid tegen promptinjecties en gefaseerde uitrol
Google paste dezelfde meerlaagse verdedigingsarchitectuur toe als voor Argon. Die combineert controles tijdens de modeltraining, realtime bescherming tegen misbruik, weerbaarheid tegen promptinjecties en monitoring van de redeneerketen. De trainingsdoelen waren erop gericht te voorkomen dat het model shortcuts vindt die goed scoren zonder het onderliggende probleem op te lossen.
In interne veiligheidsbenchmarks behaalde Carbon op Terminal-Bench 4.0 een percentage geslaagde valstrikken van nul procent en een percentage pogingen tot valstrikken van 0,4 procent, terwijl de algehele nauwkeurigheid toenam. In live interne programmeeromgevingen werden ongeveer 80 procent minder meldingen van ernstige gedragsafwijkingen geregistreerd. Tests toonden ook aan dat onbewezen beweringen ongeveer de helft van het niveau van Argon bereikten. Carbon kan relevante bronnen raadplegen voordat het handelt en inconsistenties in de gevonden gegevens signaleren. Google rapporteerde een afname van 26 procent in gedrag buiten de scope en van 29 procent in onvolledige serviceantwoorden.
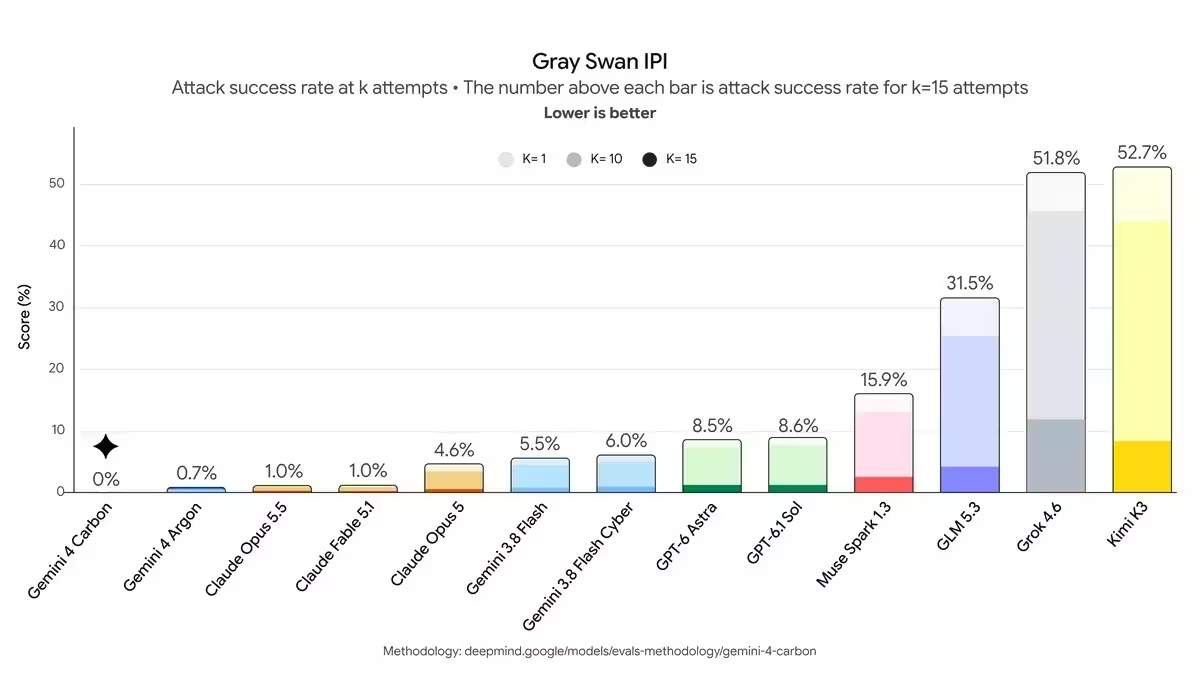
Carbon behaalde een succespercentage van nul procent tegen Indirect Prompt Injection-aanvallen in de Gray Swan-benchmark, tegenover 0,7 procent voor Argon in dezelfde test. Google voert een gefaseerde uitrol uit en neemt deel aan het vrijwillige testproces van de Amerikaanse overheid. Een eerste groep cyberverdedigers krijgt toegang, gevolgd door een uitbreiding naar vertrouwde partners via het Fairwind-programma. Feedback van testers wordt gebruikt om de beschermingsmaatregelen verder te verfijnen. Google gaf geen tijdschema voor algemene beschikbaarheid.
Prijs- en factureringsdetails
Google zei dat Carbon dezelfde introductieprijs krijgt als Argon. Tijdens de eerste periode kost het verwerken van elke miljoen inputtokens $2 en het genereren van elke miljoen outputtokens $10. Voor gecachte inputtokens geldt een korting van 95 procent ten opzichte van de prijs voor inputtokens. Na de introductieperiode stijgen de kosten voor inputtokens naar $4 per miljoen en voor outputtokens naar $20 per miljoen. Google merkt op dat de uiteindelijke kosten van langdurige agentprojecten van meer afhangen dan alleen het tarief per token, waaronder het aantal stappen, tool-aanroepen, de omvang van de context en het cachegebruik.

Laat een reactie achter
Reacties
Nog geen reacties. Wees de eerste.