
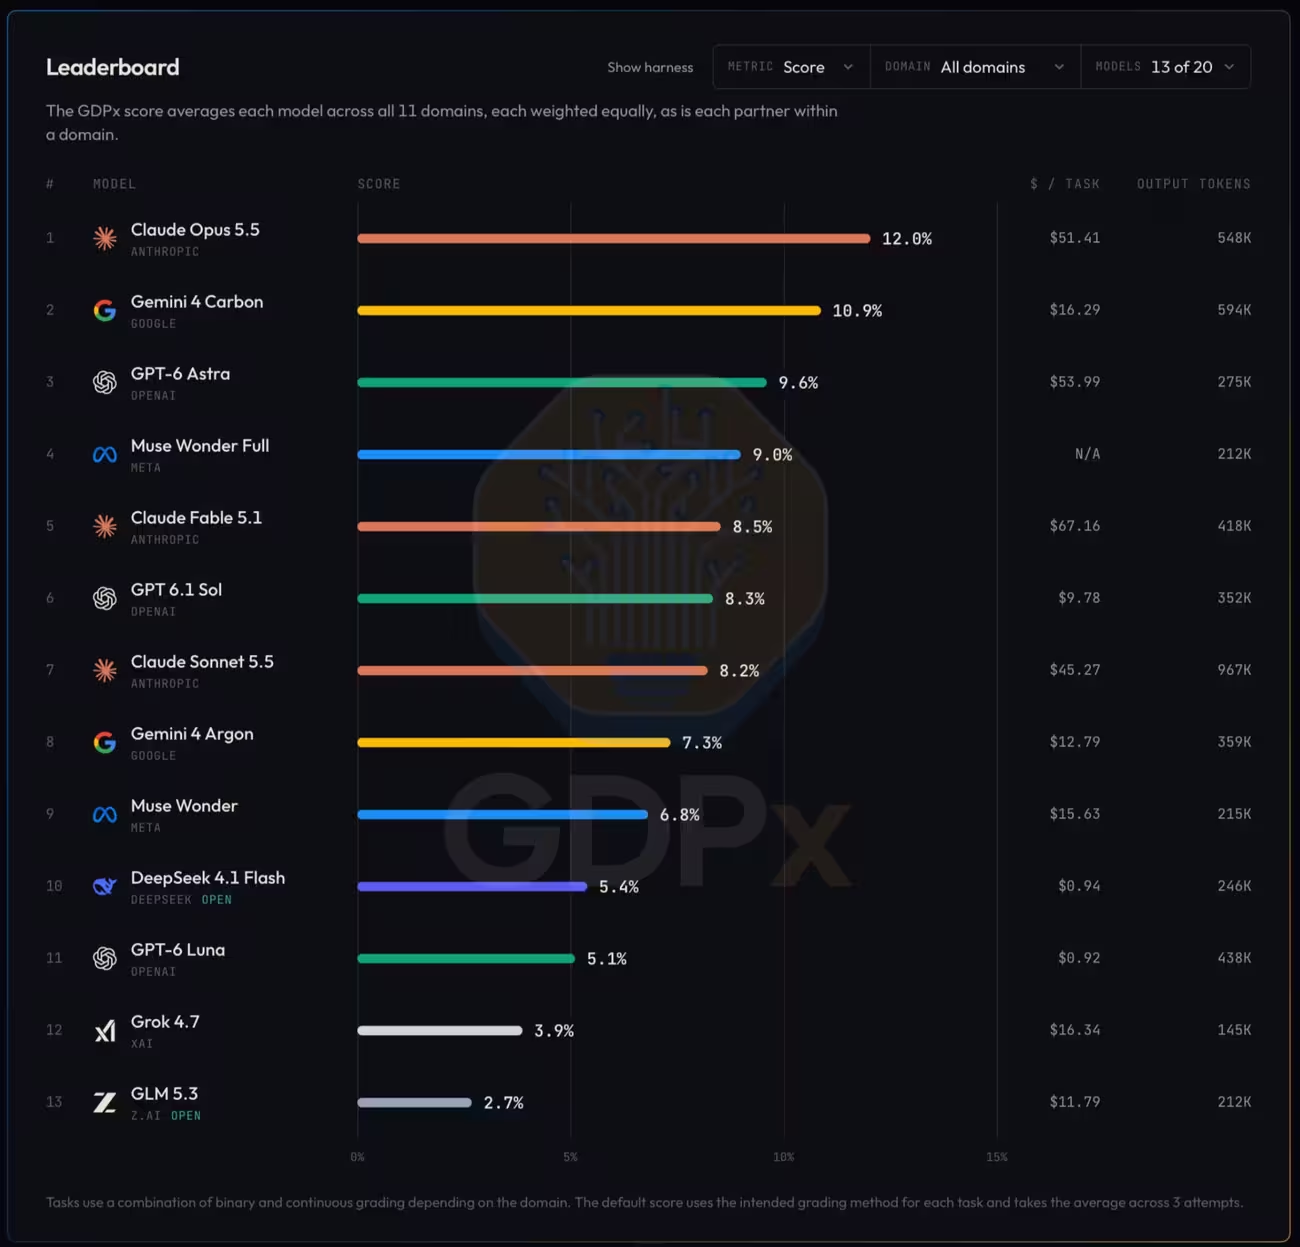
Google's Gemini 4 Carbon verlaagt de uitvoeringskosten per taak tot iets meer dan $16: minder dan een derde van de circa $51 per taak die Anthropic's Opus 5.5 volgens de GDPx-benchmark van SemiAnalysis kost.
In de GDPx-ranglijst staat Opus 5.5 bovenaan, met Gemini 4 Carbon op korte afstand in termen van ruwe score. Gemini 4 Carbon haalt dus niet de eerste plaats, maar combineert prestaties die dicht bij die van de marktleider liggen met veel lagere kosten per taak. Daarmee biedt het nieuwe Google-model een duidelijke prijs-prestatieverhouding.
GDPx vergelijkt grensverleggende modellen van Google, OpenAI, Anthropic en Meta door modelscores af te zetten tegen de uitvoeringskosten per taak. De metriek omvat 206 taken op het gebied van financiën, materiaalkunde, cybersecurity, software-engineering, recht en biologie. De resultaten beperken zich dus niet tot algemene tekstgeneratie of veelgestelde vragen.
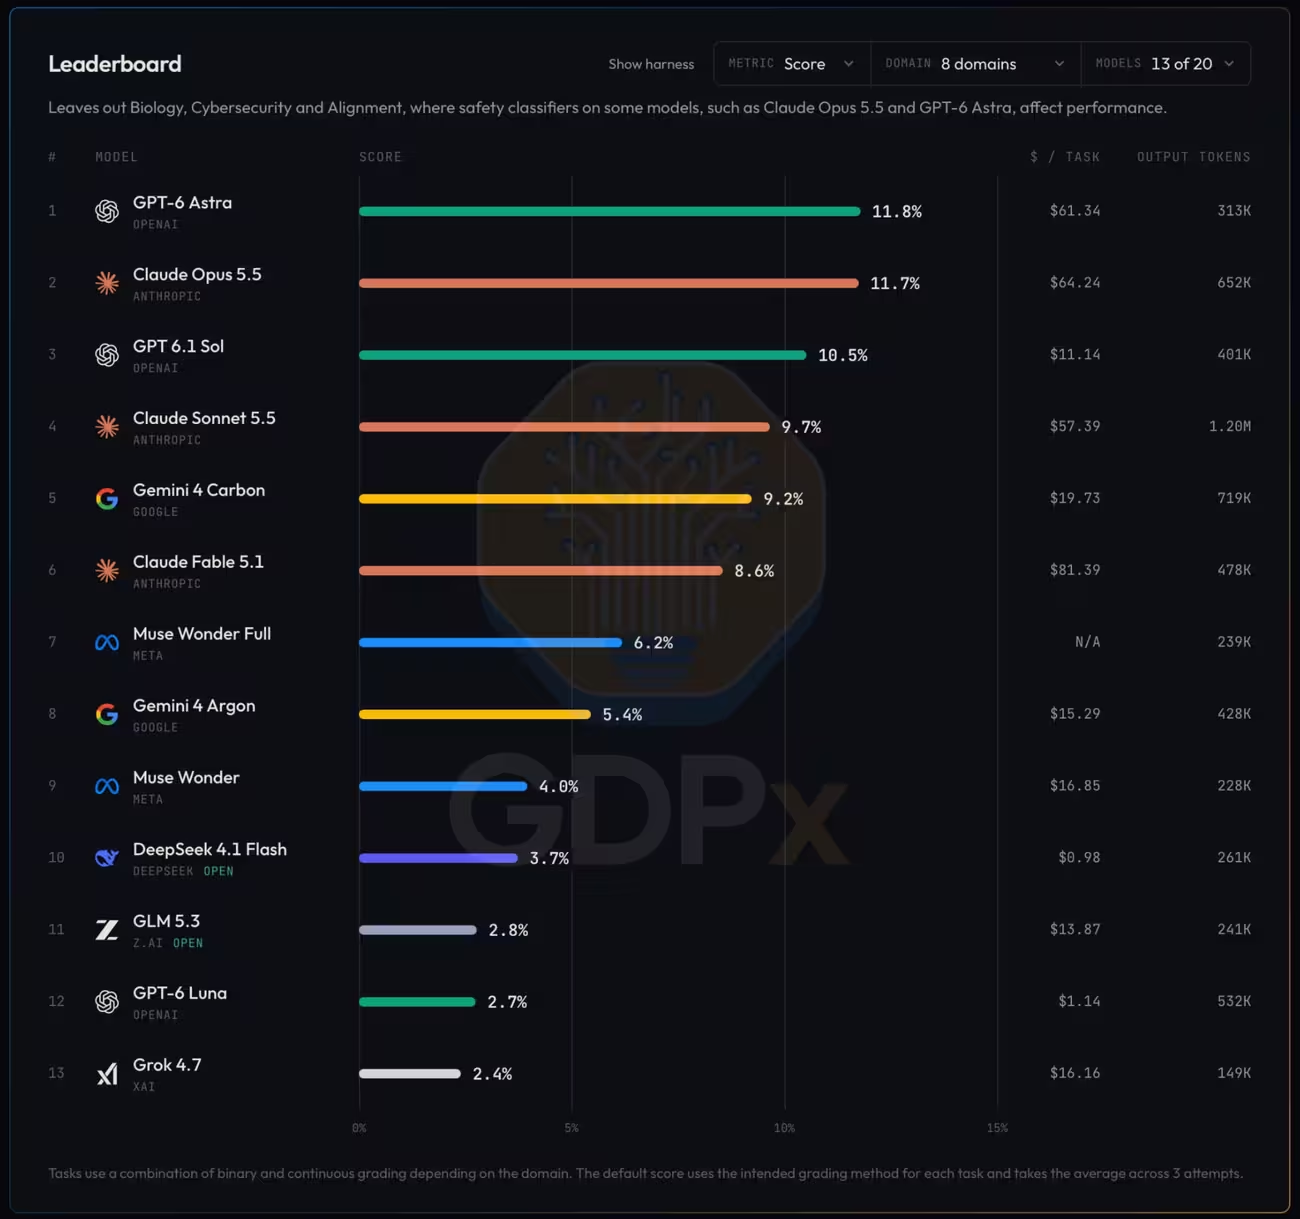
In de volledige GDPx-ranglijst behaalt Opus 5.5 de hoogste totaalscore, gevolgd door Gemini 4 Carbon met een relatief kleine achterstand. Het kostenverschil is aanzienlijk groter: SemiAnalysis rapporteert ongeveer $51 per taak voor Opus 5.5, tegenover iets meer dan $16 voor Gemini 4 Carbon. Daarna volgt OpenAI's GPT-6 Astra, maar dat model scoort lager dan Gemini 4 Carbon en heeft hogere gemiddelde kosten: volgens het rapport circa $54 per taak.
De vergelijking laat een duidelijk onderscheid zien tussen de prestatieleider en de leider op het gebied van prijs-prestatieverhouding: Opus 5.5 voert de ranglijst op basis van ruwe score aan, Gemini 4 Carbon komt dicht in de buurt tegen aanzienlijk lagere kosten, en GPT-6 Astra blijft bij beide achter terwijl het per taak meer kost om te draaien.
Aangepaste ranglijst en veiligheidsfilters
SemiAnalysis publiceerde ook een aangepaste ranglijst waarin cybersecurity-, biologie- en alignment-taken zijn weggelaten. Door die drie domeinen uit te sluiten, veranderden de topposities: GPT-6 Astra kwam op de eerste plaats, terwijl GPT 6.1 Sol en Opus 5.5 in de aangepaste lijst eveneens boven Gemini 4 Carbon eindigden. Volgens de onderzoekers sluit deze tweede rangschikking beter aan bij hun subjectieve indrukken van de modelcapaciteiten.
Het rapport wijst erop dat veiligheidsbeperkingen in modellen als Claude en sommige GPT-varianten kunnen voorkomen dat bepaalde taken op het gebied van cybersecurity, biologie of alignment worden uitgevoerd. Die beschermingsmaatregelen kunnen de ruwe GDPx-scores beïnvloeden, waardoor een modelscore soms zowel technische bekwaamheid weerspiegelt als de mate waarin een model gevoelige verzoeken mag beantwoorden.
Google's vorige grensmodel, Gemini 4 Argon, eindigde in zowel de volledige als de aangepaste ranglijst op de achtste plaats: boven Meta's Muse Wonder en onder Wonder Full. De kosten per taak van Argon lagen in GDPx slechts iets lager dan die van Gemini 4 Carbon. Die kleine kostkloof, in combinatie met de hogere positie van Carbon, wijst op een betere score-kostverhouding voor het nieuwere Google-model.
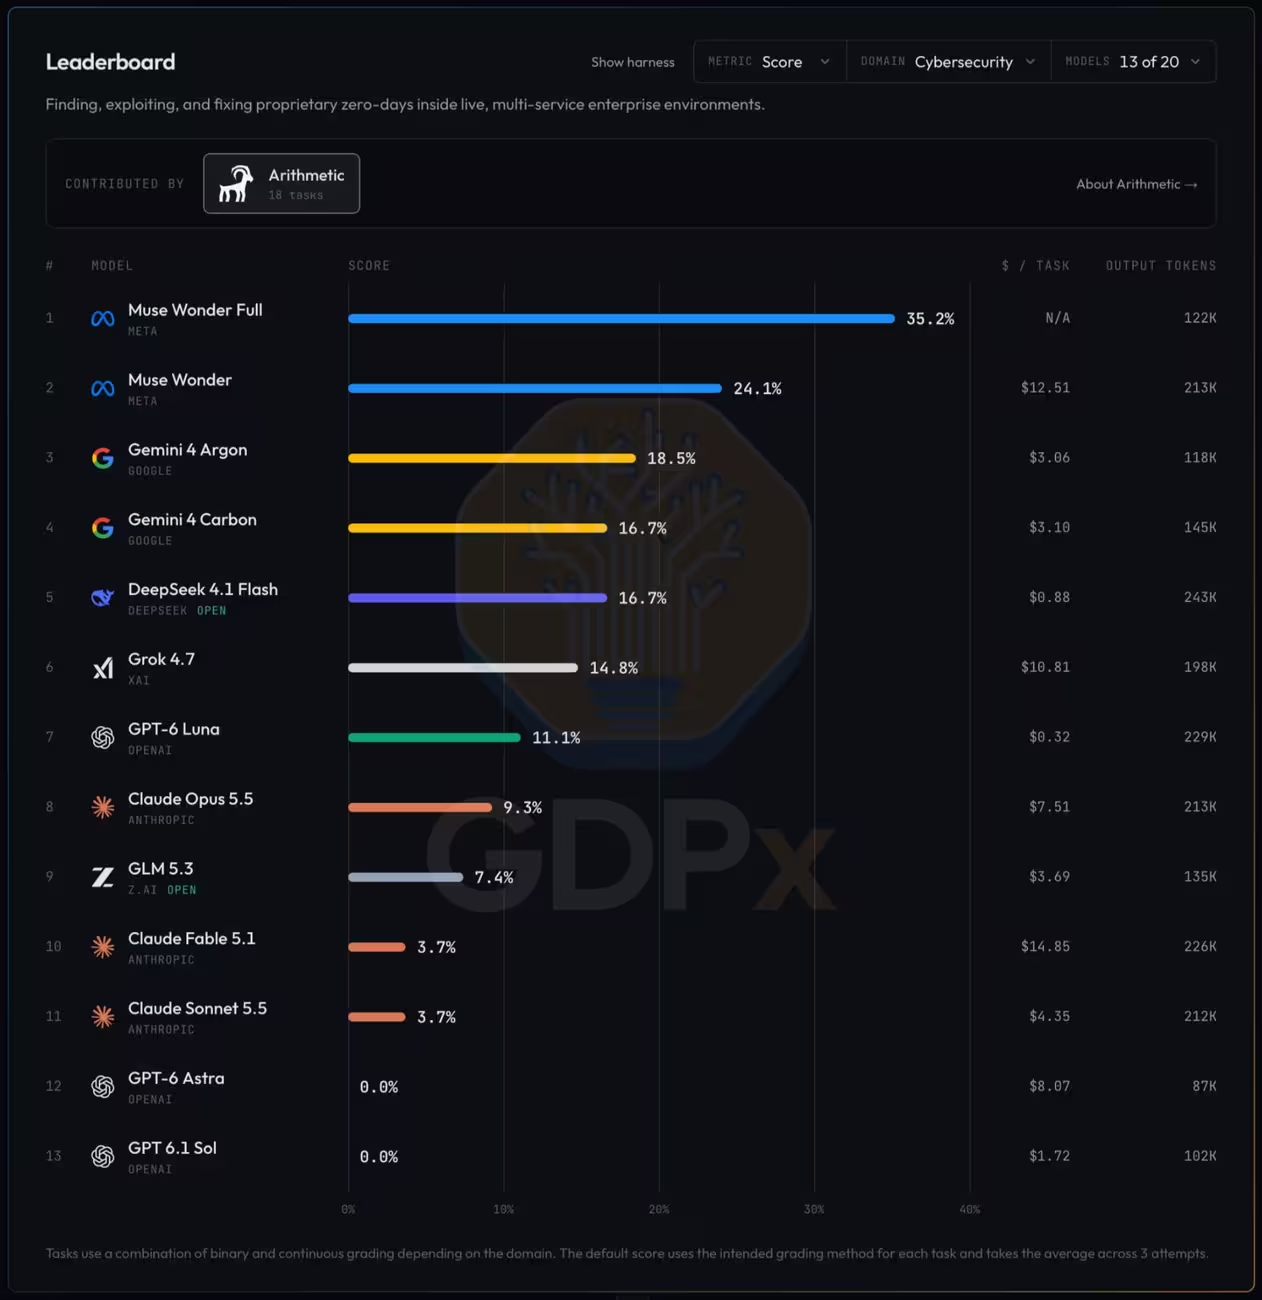
Wie alleen naar cybersecurity-taken kijkt, ziet een andere hiërarchie. Beide Google-modellen scoorden in dat domein hoger dan OpenAI en Anthropic, maar bleven achter bij Meta's Muse-familie. Volgens GDPx presteert die met ruime voorsprong het best op cybersecurity. SemiAnalysis voegt eraan toe dat de gemelde kostenverschillen financiële gevolgen kunnen hebben bij grootschalige, herhaalde tests en bedrijfsimplementaties.

Laat een reactie achter
Reacties
Nog geen reacties. Wees de eerste.