

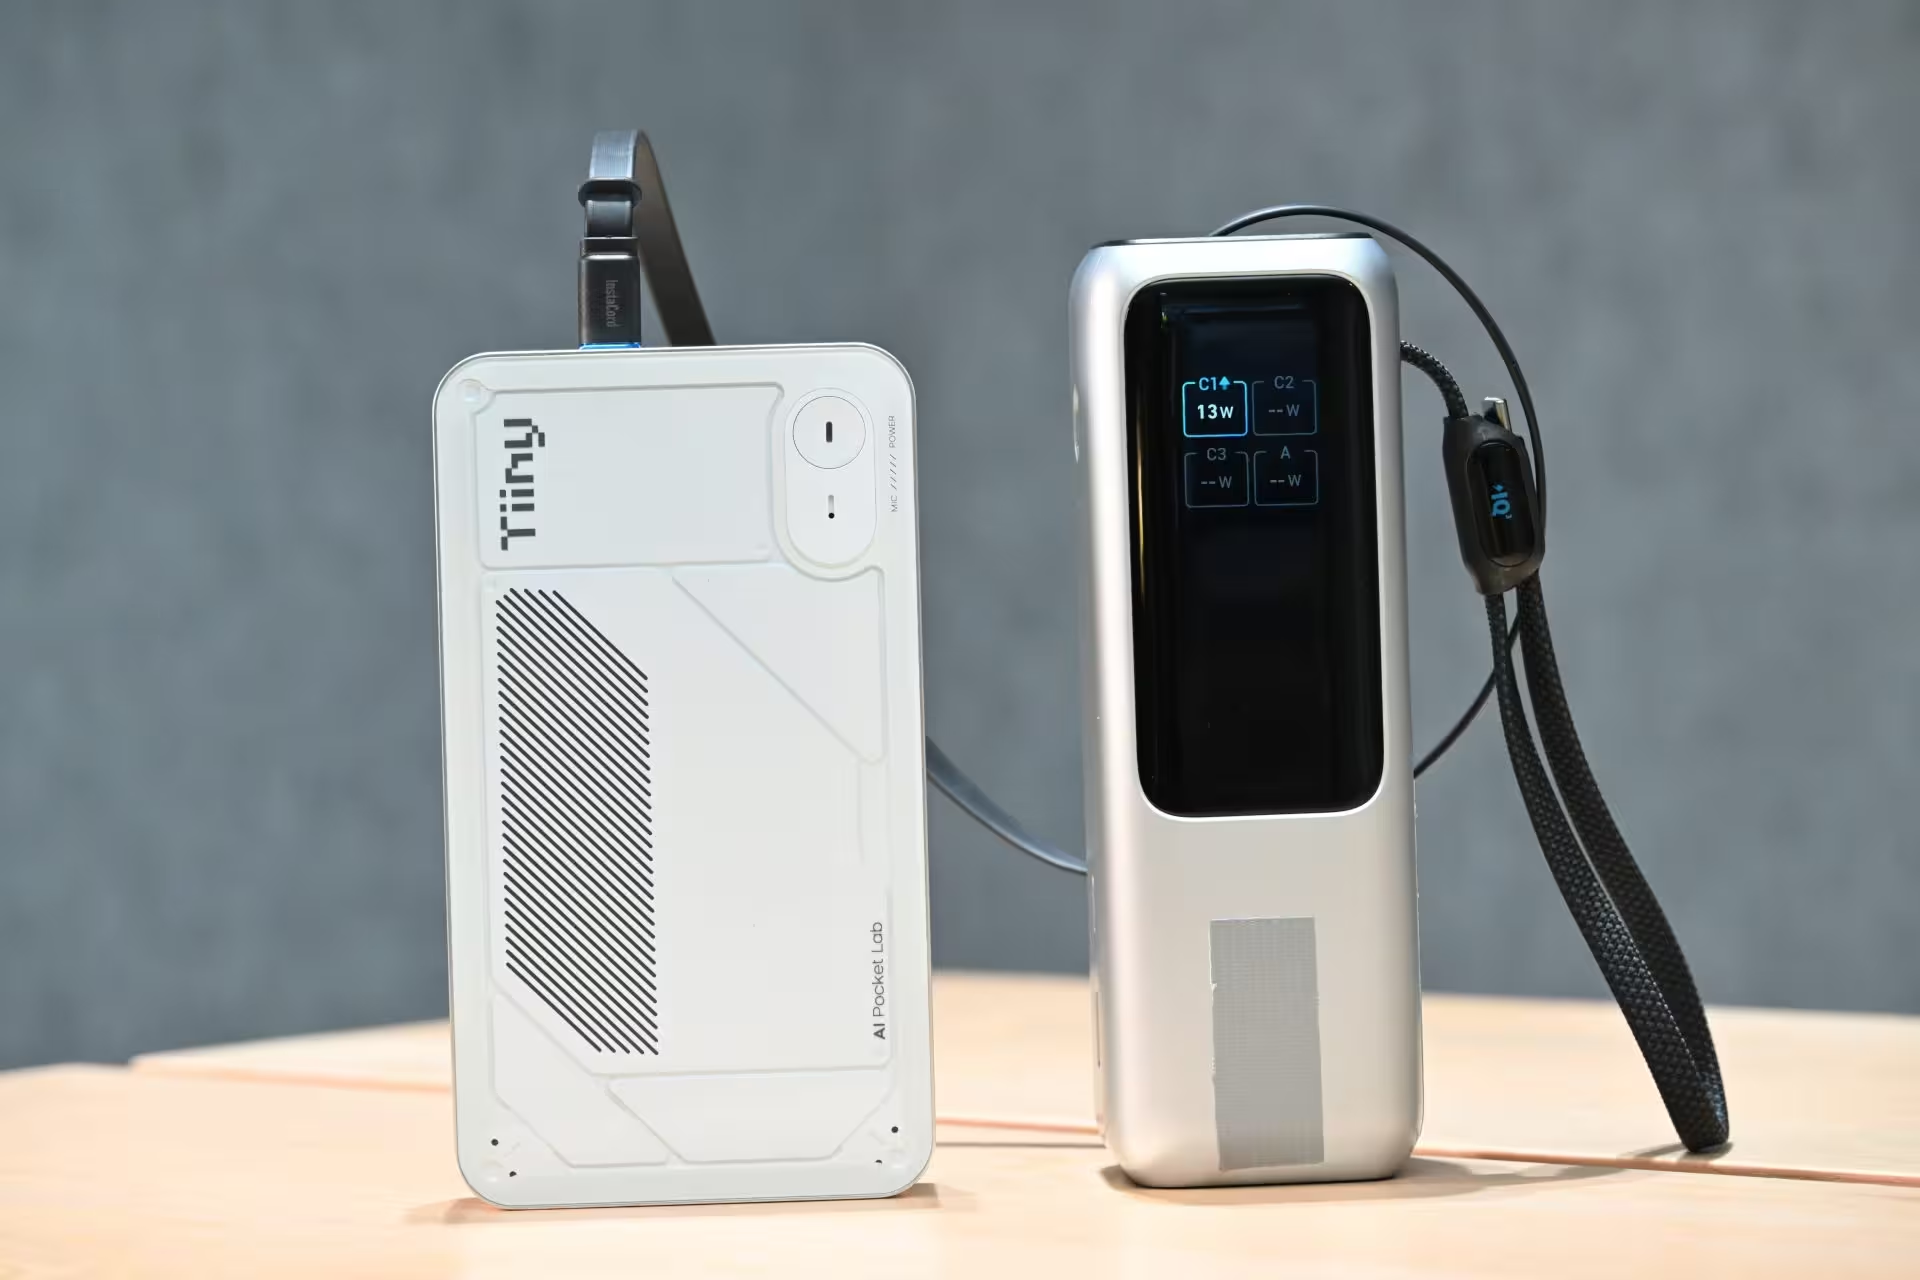
Tiiny AI gokt dat de volgende sprong in AI-hardware niet in een datacenterrek plaatsvindt, maar in je hand past. De startup onthulde de Pocket Lab, een handpalmformaat "supercomputer" ontworpen om 120-miljard-parameter large language models (LLM’s) volledig offline te draaien.
Small device, big claims
Laat je niet misleiden door de afmetingen. Met ongeveer 14,2 × 8 × 2,53 cm en circa 300 gram is de Pocket Lab echt draagbaar. Tegelijkertijd stelt Tiiny AI dat het apparaat zware open modellen kan herbergen die normaal gesproken kostbare GPU-clusters vereisen. Het belooft redenering op PhD-niveau, complexe meerstapsanalyses en diepe contextuele begrip zonder afhankelijkheid van de cloud.
Die ambitie valt samen met een bredere trend in edge AI en lokale LLM-executie: ontwikkelaars en bedrijven zoeken steeds vaker naar oplossingen die privacy, lage latency en onafhankelijke werking combineren. De Pocket Lab positioneert zich in dat landschap als een apparaat dat krachtige inferentie en ontwikkelgemak wil leveren voor onderzoek, prototyping en privacy-gevoelige toepassingen.
Specs that explain the hype
Op papier leest de Pocket Lab als een gecondenseerde server. Belangrijke specificaties zijn onder meer:
- ARMv9.2 12-core CPU voor algemene compute-taken
- Een op maat gemaakt heterogeen compute-module (SoC + discrete NPU) die ongeveer 190 TOPS levert
- 80 GB LPDDR5X-geheugen en een 1 TB SSD voor residentie van grote modellen en snelle I/O
- Vermogen om tot 120B-parameter LLM’s volledig op apparaat uit te voeren door agressieve quantisatie
- Vermogensprofiel gericht op ~30W TDP en ~65W typisch systeemverbruik — veel lager dan vergelijkbare serveropstellingen
- Offline-eerst werking met één-klik implementatie voor veel open-source LLM’s en agent-frameworks
Deze specificaties schetsen waarom Tiiny AI spreekt over een "pocket supercomputer": de combinatie van een hoge mate van rekenkracht (in TOPS), veel snel geheugen en lokale opslag creëert op papier de voorwaarden om grote modellen lokaal te huisvesten en te bedienen.
Belangrijk is te benadrukken dat specificaties zoals TOPS en geheugenlatenties vaak afhangen van de werkelijke softwarestack, quantisatiekwaliteit en het modelontwerp. In de praktijk bepalen runtime-optimalisaties, geheugenlayout en I/O-patronen of een apparaat daadwerkelijk serverachtige prestaties kan benaderen.

How does it pull off 120B models in your pocket?
Het geheim is een combinatie van hardware-dichtheid en slimme software. De Pocket Lab bevat een discrete NPU die hoge TOPS aankan, maar Tiiny AI vertrouwt ook op twee kerntechnieken om grote modellen praktisch te houden op beperkte siliconenruimte:
- TurboSparse — een neuron-niveau sparse-activatiebenadering die de efficiëntie van inferentie verhoogt zonder de redeneringskracht van het model significant te verslechteren. In essentie vermindert TurboSparse het aantal noodzakelijke berekeningen door activaties selectief te negeren, wat leidt tot minder geheugen- en rekenbelasting bij vergelijkbare outputkwaliteit.
- PowerInfer — een open-source heterogeen inferentie-engine (veel gebruikt en gedocumenteerd op GitHub) die taken dynamisch tussen CPU en NPU verdeelt. PowerInfer orkestreert berekeningen zodat de werkverdeling serverachtige throughput imiteert, maar met een fractie van het typische energieverbruik.
Gekoppeld aan 80 GB LPDDR5X, die voldoende bandbreedte biedt voor agressieve quantisatie en geheugen-efficiënte uitvoering, maken deze technieken het draaien van 120B-modellen lokaal meer plausibel dan louter theoretisch. De combinatie van quantisatie (bijvoorbeeld 4-bit of gestructureerde quantisatie), geheugencompressie en sparse-activatie zorgt ervoor dat modelgewichten en activaties binnen de beschikbare RAM passen en dat de NPU efficiënt benut wordt.
In de praktijk bestaan er altijd trade-offs: hogere quantisatieniveaus kunnen lagere nauwkeurigheid veroorzaken, en sparsity-technieken vereisen vaak recalibratie of finetuning om prestaties te behouden. Tiiny AI’s aanpak lijkt te focussen op een evenwicht waarbij artefacten tot een minimum worden beperkt terwijl latency en energieverbruik sterk afnemen.
Models, privacy, and real-world uses
De Pocket Lab ondersteunt een breed catalogus van open modellen — van GPT-OSS en Llama tot Qwen, Mistral en Phi — waardoor ontwikkelaars de architectuur kunnen kiezen die het beste bij hun toepassing past. Omdat het apparaat volledig offline werkt, is het aantrekkelijk voor privacygerichte implementaties, veldonderzoek en ontwikkelaars die snelle iteratie willen zonder cloud-latentie of terugkerende kosten.
Praktische toepassingen variëren van prototyping van agent-workflows en lokale NLP-verwerking tot specifieke domeinen zoals medisch onderzoek, juridische documenten-analyse of defensie- en industriële automatisering waar dataprivacy en veiligheid cruciaal zijn. Offline LLM-executie vermindert de noodzaak om gevoelige data naar externe servers te sturen en verlaagt daardoor het risico op datalekken of onbedoelde gegevensverwerking door derden.
Voor ontwikkelaars biedt een lokaal apparaat ook voordelen in termen van iteratie-snelheid: modellen laden en testen gaat sneller zonder netwerk-IO, en debugging van latency- of geheugenproblemen kan direct op hardware worden uitgevoerd. Bovendien creëert lokale inferentie nieuwe mogelijkheden voor mobile-first applicaties, realtime conversie en spraak-naar-tekst-werkstromen in omgevingen zonder betrouwbare netwerkinfrastructuur.
Toch zijn er grenzen: sommige productieworkloads, grootschalige trainingstaken of ensemble-inferenties blijven beter geschikt voor server- of cloudgebaseerde clusters. De Pocket Lab richt zich vooral op inferentie en lichtgewicht finetuning of parameter-efficient adaptation (zoals LoRA), niet op volledige modeltraining op grote schaal.
What’s next: CES and questions to answer
Tiiny AI plant een demonstratie van de Pocket Lab op CES 2026. Het bedrijf heeft nog geen prijs of leveringsdatum aangekondigd, en echte wereldbenchmarks zullen de doorslaggevende toets zijn: kan een pocketformaat machine consequent server-grade workloads aan in diverse scenario’s?
Bij publieke demo’s en vroege benchmarks moet vooral worden gelet op praktische metrics zoals latency per token, throughput bij conversatiestromen, energie-efficiëntie onder echte belasting en de mate van nauwkeurigheid versus referentiemodellen op serverhardware. Daarnaast zijn robuustheidstests, foutafhandeling, thermisch throttling-gedrag en levensduur onder continue belasting cruciale indicatoren van volwassenheid.
Ondanks die open vragen signaleert de Pocket Lab een interessante verschuiving. Edge AI gaat verder dan kleine sensoren en komt in praktijkgerichte, krachtige privé-computeplatforms terecht — iets dat kan veranderen hoe ontwikkelaars, onderzoekers en privacy-bewuste gebruikers met LLM’s werken.
De impact strekt zich uit tot bedrijfsarchitectuur en compliance: organisaties die regelgeving en databeperkingen ondervinden, bijvoorbeeld in de EU met strikte privacywetten, kunnen lokaal draaien en daarmee risico’s en compliancekosten verlagen. Tegelijkertijd openen dergelijke apparaten nieuwe marktkansen voor softwareleveranciers die offline-first AI-oplossingen leveren.
Belangrijke vragen die Tiiny AI en de bredere community nog moeten beantwoorden, zijn onder andere:
- Hoe verhoudt de modelnauwkeurigheid zich tot serverimplementaties op standaard NLP-benchmarks na quantisatie?
- Welke toolchain en SDK’s worden aangeboden voor ontwikkelaars, en hoe eenvoudig is het om bestaande workflows te porteren?
- Hoe robuust is de beveiliging van het apparaat tegen fysieke en softwarematige aanvallen, en welke accreditaties of third-party audits zijn gepland?
Antwoorden op deze vragen worden verwacht tijdens productdemonstraties, onafhankelijke benchmarks en vroege adopterscenario’s na verzending.
Technische nuances en optimalisaties
Om het verhaal technisch verder te duiden: het succesvol draaien van 120B LLM’s op een apparaat als de Pocket Lab vereist meerdere lagen van optimalisatie die samenwerken:
- Modelarchitectuur-aanpassingen: sommige LLM-varianten zijn efficiënter te kwantiseren of reageren beter op sparsity zonder significante accuracy-degradatie.
- Geavanceerde quantisatie-technieken: naast statische 8-bit quantisatie omvatten moderne stacks 4-bit, mixed-precision en blockwise quantisatie die geheugen en rekency verminderen.
- Geheugenlayout en streaming I/O: slimme paging en activatie-stroombeheer voorkomen dat het systeem bottleneckt op SSD-naar-RAM transfers tijdens langere inferentieketens.
- Heterogene orkestratie: runtime-engines zoals PowerInfer beheren taaktoewijzing tussen CPU, NPU en eventueel vector-accelerators om geheugenbandbreedte en rekenunits optimaal te benutten.
Verder spelen profiling- en observability-tools een cruciale rol voor ontwikkelaars die modellen willen tunen voor lokale uitvoering. Metrics zoals cache-misses, NPU-utilisatie, latency-p95 en energieper-token bieden inzicht in knelpunten en optimalisatiemogelijkheden.
Vanuit onderzoeksoptiek kan de Pocket Lab ook dienen als platform voor experimentele inference-methoden, modelkompressie en privacy-preserving technieken zoals lokale differential privacy of secure enclaves wanneer gecombineerd met hardwarebeveiliging.
Concurrentie en positionering in de markt
De Pocket Lab komt op een markt waar zowel special-purpose edge-accelerators als software-gedreven oplossingen concurreren. Concurrenten zijn onder meer bedrijven die NPU-gestuurde edge-servers, compacte AI-werkstations en gespecialiseerde inference-apparaten aanbieden. Waar Tiiny AI zich onderscheidt, is de combinatie van:
- Een zeer draagbaar formaat met relatief hoge TOPS
- Een focus op het draaien van 120B-klasse LLM’s volledig offline
- Open-source integratie (bijv. ondersteuning voor populaire open modellen en tooling zoals PowerInfer)
Deze differentiatie sluit aan op een specifieke gebruikersgroep: onderzoekers en bedrijven die krachtige lokale inferentie willen zonder de complexiteit en kosten van cloud-voorraad of grootschalige datacenterinfrastructuur.
Desondanks zal prijsstelling, ecosysteemondersteuning en softwarecompatibiliteit bepalend zijn voor marktsucces. Een sterke developer-ervaring met goede documentatie, voorbeeldworkflows en compatibiliteit met bestaande modelformaten (zoals Hugging Face checkpoints, ONNX of andere open formaten) kan de adoptie aanzienlijk versnellen.
Beperkingen en overwegingen
Hoewel het concept veel belooft, zijn er praktische beperkingen en overwegingen die potentiële gebruikers in ogenschouw moeten nemen:
- Thermisch beheer: compacte formaten moeten efficiënt warmte afvoeren om throttling en performanceverlies te voorkomen.
- Modelcompatibiliteit: niet alle LLM-architecturen vertalen even goed naar sterke quantisatie of sparsity-optimalisaties zonder aanvullende finetuning.
- Ondersteuning en updatebeleid: langdurige veiligheid en modelupdates zijn cruciaal, vooral in productieomgevingen.
- Kosten per prestatie: relatief hoge hardwarekost voor een niche-apparaat kan de ROI voor sommige toepassingen beïnvloeden.
Het is raadzaam dat geïnteresseerde organisaties proefimplementaties uitvoeren en nauw samenwerken met Tiiny AI of partners om integratie- en beveiligingsvereisten te valideren voordat ze in productie gaan.
Samenvattend
De Pocket Lab van Tiiny AI is een interessante stap in de ontwikkeling van krachtige, draagbare edge-AI-apparaten. Met technische innovaties zoals TurboSparse en PowerInfer, gecombineerd met een robuuste hardwarebasis (80 GB LPDDR5X, 190 TOPS NPU), streeft het apparaat ernaar om lokaal draaien van 120B-modellen praktisch en toegankelijk te maken.
Of dat in alle relevante scenario’s zal lukken, hangt af van onafhankelijke benchmarks, softwarecompatibiliteit en hoe goed de implementatie omgaat met quantisatie- en sparsity-trade-offs. Als de Pocket Lab zijn beloften kan waarmaken, biedt het een nieuw pad voor privacygerichte AI, snelle ontwikkeling en offline-intelligentie buiten het datacenter.
Voor ontwikkelaars en organisaties betekent dit een kans: experimenteer vroeg, meet nauwkeurig en evalueer welke workloads echt profiteren van lokale LLM-executie versus cloud- of hybride oplossingen.

Laat een reactie achter
Reacties (3)
Feestje voor marketing? voelt wel wat overhyped, vooral zonder onafhankelijke benchmarks. Probeer eerst hands-on tests, anders beetje risky
Wow, dit zou echt een gamechanger voor privacy kunnen zijn… maar tegelijk zenuwachtig dat het vooral marketing-talk is. show me the benchmarks pls
Klinkt te mooi om waar te zijn. 120B in je hand? Hoe zit het met throttling batterij en echte accuracy tests, iemand die al hands-on is?